Domain klinikschuhe.de kaufen?
Wir ziehen mit dem Projekt
klinikschuhe.de um.
Sind Sie am Kauf der Domain
klinikschuhe.de interessiert?
domain@kv-gmbh.de · 0541-91531010
Domain klinikschuhe.de kaufen?
Was sind die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Datenquellen?
Die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning-Algorithmen können verwendet werden, um Muster und Zusammenhänge in den Daten zu erkennen und relevante Informationen zu extrahieren. **
Was sind die gängigen Methoden zur Informationsextraktion aus unstrukturierten Texten?
Die gängigen Methoden zur Informationsextraktion aus unstrukturierten Texten sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen durch statistische Analysen und Mustererkennung. Natural Language Processing ermöglicht die Verarbeitung von natürlicher Sprache, um relevante Informationen zu extrahieren. Machine Learning nutzt Algorithmen, um automatisch Muster in unstrukturierten Texten zu erkennen und Informationen zu extrahieren. **


Ähnliche Suchbegriffe für Informationsextraktion
Top-Angebote
Produkte zum Begriff Informationsextraktion:
-
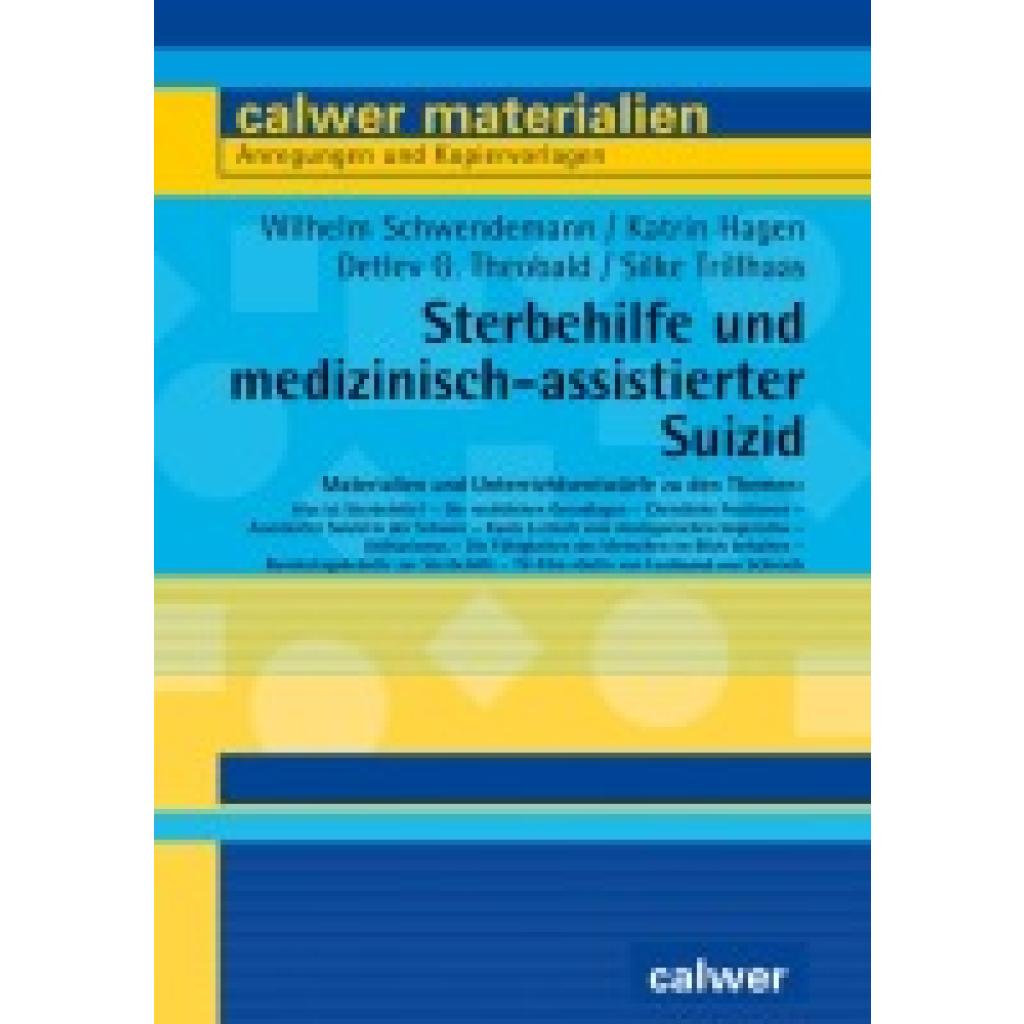
Schwendemann, Wilhelm: Sterbehilfe und medizinisch-assistierter SuizidSterbehilfe und medizinisch-assistierter Suizid , Materialien und Unterrichtsentwürfe , Zündkerzen > Elektrik & Zündungen , Auflage: 3., aktualisierte und ergänzte Auflage, Erscheinungsjahr: 20211008, Produktform: Kartoniert, Titel der Reihe: Calwer Materialien##, Autoren: Schwendemann, Wilhelm~Hagen, Katrin~Theobald, Detlev G., Auflage: 21003, Auflage/Ausgabe: 3., aktualisierte und ergänzte Auflage, Seitenzahl/Blattzahl: 96, Keyword: Kopiervorlagen; Oberstufe; Utilitarismus; kategorischer Imperativ, Fachschema: Ethik / Lehrermaterial, Themenvorschläge~Religionsunterricht / Lehrermaterial, Themenvorschläge~Sterbehilfe~Ethik~Ethos~Philosophie / Ethik~Christentum~Weltreligionen / Christentum, Bildungsmedien Fächer: Ethik ~Religion, Fachkategorie: Unterrichtsmaterialien~Ethik und Moralphilosophie~Theologische Ethik~Christentum~Religiöse Unterweisung, Religionsunterricht~Unterricht und Didaktik: Religion, Bildungszweck: für die Sekundarstufe I~für die Sekundarstufe II~für die Berufsbildung, Altersempfehlung / Lesealter: 23, Genaues Alter: ABI, Warengruppe: HC/Schulbücher/Unterrichtsmat./Lehrer, Fachkategorie: Ethische Themen: Sterbehilfe & Recht zu Sterben, Thema: Verstehen, Schulform: ABI, Text Sprache: ger, UNSPSC: 49019900, Warenverzeichnis für die Außenhandelsstatistik: 49019900, Verlag: Calwer Verlag GmbH, Verlag: Calwer Verlag GmbH, Verlag: Calwer Verlag GmbH Bcher und Medien, Länge: 305, Breite: 212, Höhe: 3, Gewicht: 329, Produktform: Kartoniert, Genre: Schule und Lernen, Genre: Schule und Lernen, Vorgänger EAN: 9783766844224, Herkunftsland: POLEN (PL), Katalog: deutschsprachige Titel, Katalog: Gesamtkatalog, Katalog: Lagerartikel, Book on Demand, ausgew. Medienartikel, Relevanz: 0012, Tendenz: +1, Unterkatalog: AK, Unterkatalog: Bücher, Unterkatalog: Hardcover, Unterkatalog: Lagerartikel, Unterkatalog: Schulbuch,20,95 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Angewandte Informationsextraktion und Sentimentanalyse, Taschenbuch von Ashraf Uddin,Rajesh Piryani,Vivek Kumar Singh, Verlag Unser Wissen,Angewandte Informationsextraktion Und Sentimentanalyse, Taschenbuch Von Ashraf Uddin,rajesh Piryani,vivek Kumar Singh, Verlag Unser Wissen, 978-620-9-62581-7, Seitenanzahl: 8043,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Bereichsspezifische Informationsextraktion für semantische Annotation, Taschenbuch von Zeeshan Ahmed, BoD - Books on Demand, 978-620-2-73428-8Bereichsspezifische Informationsextraktion Für Semantische Annotation, Taschenbuch Von Zeeshan Ahmed, Bod - Books On Demand, 978-620-2-73428-8, Seitenanzahl: 8426,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter



-
Was sind die gängigsten Techniken zur Informationsextraktion aus unstrukturierten Datenquellen?
Die gängigsten Techniken zur Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning Algorithmen können dabei helfen, Muster und Zusammenhänge in den Daten zu erkennen und relevante Informationen zu extrahieren. **
-
Was sind die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Daten?
Die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Daten sind Text Mining, Natural Language Processing (NLP) und Machine Learning. Text Mining analysiert große Mengen von Textdaten, um Muster und Trends zu identifizieren. NLP ermöglicht die Verarbeitung und Interpretation von natürlicher Sprache, während Machine Learning Algorithmen verwendet, um automatisch Muster und Informationen aus den Daten zu extrahieren. **
-
Was sind die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Daten?
Die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Daten sind Text Mining, Natural Language Processing und Machine Learning. Text Mining ermöglicht die Extraktion von relevanten Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning-Algorithmen können dabei helfen, Muster und Zusammenhänge in den Daten zu erkennen und automatisch Informationen zu extrahieren. **
-
Was sind die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Texten?
Die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Texten sind Text Mining, Natural Language Processing (NLP) und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen durch statistische und linguistische Analyse. NLP ermöglicht die Verarbeitung und Interpretation von natürlicher Sprache, während Machine Learning Algorithmen verwendet, um Muster und Zusammenhänge in den Texten zu erkennen. **

Was sind die wichtigsten Techniken zur Informationsextraktion aus unstrukturierten Texten?
Die wichtigsten Techniken zur Informationsextraktion aus unstrukturierten Texten sind Textklassifikation, Named Entity Recognition und Sentimentanalyse. Textklassifikation hilft dabei, relevante Informationen zu identifizieren, während Named Entity Recognition Namen, Orte und andere wichtige Entitäten extrahiert. Sentimentanalyse ermöglicht die Bewertung von Meinungen und Stimmungen in Texten. **
Was sind die Schlüsseltechniken für die Informationsextraktion aus unstrukturierten Datenquellen?
Die Schlüsseltechniken für die Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining ermöglicht die Identifizierung von relevanten Informationen in unstrukturierten Texten. Natural Language Processing hilft bei der Verarbeitung und Analyse von natürlicher Sprache. Machine Learning ermöglicht die Automatisierung von Extraktionsprozessen durch das Trainieren von Algorithmen auf vorhandenen Daten. **
Top-Angebote
Produkte zum Begriff Informationsextraktion:
-
Angebotsbeschreibungen für Online-Einkaufsportale zur automatischen Klassifizierung und Informationsextraktion mittels RekursiverAngebotsbeschreibungen Für Online-einkaufsportale Zur Automatischen Klassifizierung Und Informationsextraktion Mittels Rekursiver Transitionsnetzwerke, Taschenbuch Von Anja Klein, Grin, 978-3-668-14793-5, Seitenanzahl: 6427,95 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Schwendemann, Wilhelm: Sterbehilfe und medizinisch-assistierter SuizidSterbehilfe und medizinisch-assistierter Suizid , Materialien und Unterrichtsentwürfe , Zündkerzen > Elektrik & Zündungen , Auflage: 3., aktualisierte und ergänzte Auflage, Erscheinungsjahr: 20211008, Produktform: Kartoniert, Titel der Reihe: Calwer Materialien##, Autoren: Schwendemann, Wilhelm~Hagen, Katrin~Theobald, Detlev G., Auflage: 21003, Auflage/Ausgabe: 3., aktualisierte und ergänzte Auflage, Seitenzahl/Blattzahl: 96, Keyword: Kopiervorlagen; Oberstufe; Utilitarismus; kategorischer Imperativ, Fachschema: Ethik / Lehrermaterial, Themenvorschläge~Religionsunterricht / Lehrermaterial, Themenvorschläge~Sterbehilfe~Ethik~Ethos~Philosophie / Ethik~Christentum~Weltreligionen / Christentum, Bildungsmedien Fächer: Ethik ~Religion, Fachkategorie: Unterrichtsmaterialien~Ethik und Moralphilosophie~Theologische Ethik~Christentum~Religiöse Unterweisung, Religionsunterricht~Unterricht und Didaktik: Religion, Bildungszweck: für die Sekundarstufe I~für die Sekundarstufe II~für die Berufsbildung, Altersempfehlung / Lesealter: 23, Genaues Alter: ABI, Warengruppe: HC/Schulbücher/Unterrichtsmat./Lehrer, Fachkategorie: Ethische Themen: Sterbehilfe & Recht zu Sterben, Thema: Verstehen, Schulform: ABI, Text Sprache: ger, UNSPSC: 49019900, Warenverzeichnis für die Außenhandelsstatistik: 49019900, Verlag: Calwer Verlag GmbH, Verlag: Calwer Verlag GmbH, Verlag: Calwer Verlag GmbH Bcher und Medien, Länge: 305, Breite: 212, Höhe: 3, Gewicht: 329, Produktform: Kartoniert, Genre: Schule und Lernen, Genre: Schule und Lernen, Vorgänger EAN: 9783766844224, Herkunftsland: POLEN (PL), Katalog: deutschsprachige Titel, Katalog: Gesamtkatalog, Katalog: Lagerartikel, Book on Demand, ausgew. Medienartikel, Relevanz: 0012, Tendenz: +1, Unterkatalog: AK, Unterkatalog: Bücher, Unterkatalog: Hardcover, Unterkatalog: Lagerartikel, Unterkatalog: Schulbuch,20,95 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Was sind die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Datenquellen?
Die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning-Algorithmen können verwendet werden, um Muster und Zusammenhänge in den Daten zu erkennen und relevante Informationen zu extrahieren. **
-
Was sind die gängigen Methoden zur Informationsextraktion aus unstrukturierten Texten?
Die gängigen Methoden zur Informationsextraktion aus unstrukturierten Texten sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen durch statistische Analysen und Mustererkennung. Natural Language Processing ermöglicht die Verarbeitung von natürlicher Sprache, um relevante Informationen zu extrahieren. Machine Learning nutzt Algorithmen, um automatisch Muster in unstrukturierten Texten zu erkennen und Informationen zu extrahieren. **
-
Was sind die gängigsten Techniken zur Informationsextraktion aus unstrukturierten Datenquellen?
Die gängigsten Techniken zur Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning Algorithmen können dabei helfen, Muster und Zusammenhänge in den Daten zu erkennen und relevante Informationen zu extrahieren. **
-
Was sind die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Daten?
Die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Daten sind Text Mining, Natural Language Processing (NLP) und Machine Learning. Text Mining analysiert große Mengen von Textdaten, um Muster und Trends zu identifizieren. NLP ermöglicht die Verarbeitung und Interpretation von natürlicher Sprache, während Machine Learning Algorithmen verwendet, um automatisch Muster und Informationen aus den Daten zu extrahieren. **
Ähnliche Suchbegriffe für Informationsextraktion
-
Angewandte Informationsextraktion und Sentimentanalyse, Taschenbuch von Ashraf Uddin,Rajesh Piryani,Vivek Kumar Singh, Verlag Unser Wissen,Angewandte Informationsextraktion Und Sentimentanalyse, Taschenbuch Von Ashraf Uddin,rajesh Piryani,vivek Kumar Singh, Verlag Unser Wissen, 978-620-9-62581-7, Seitenanzahl: 8043,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Bereichsspezifische Informationsextraktion für semantische Annotation, Taschenbuch von Zeeshan Ahmed, BoD - Books on Demand, 978-620-2-73428-8Bereichsspezifische Informationsextraktion Für Semantische Annotation, Taschenbuch Von Zeeshan Ahmed, Bod - Books On Demand, 978-620-2-73428-8, Seitenanzahl: 8426,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Modell zur Informationsextraktion für Afan Oromo Nachrichtentexte, Taschenbuch von Sisay Abera, Verlag Unser Wissen, 978-620-5-59255-7Modell Zur Informationsextraktion Für Afan Oromo Nachrichtentexte, Taschenbuch Von Sisay Abera, Verlag Unser Wissen, 978-620-5-59255-7, Seitenanzahl: 6849,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
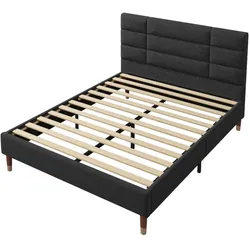
Polsterbett 140x200 mit Lattenrost Kopfteil Stauraum Leinenbezug 7-Zonen Orthopädisch ergonomisch stabil komfortabel klassisch schwarzDieses Polsterbett vereint ergonomische Unterstützung mit einem klassischen Design, das sich mühelos in jede Schlafzimmergestaltung einfügt. Die 7-Zonen-Orthopädische Unterstützung der Matratze passt sich perfekt Ihrer Körperform an und bietet gezielte Unterstützung für eine erholsame Nachtruhe. Das hautfreundliche Leinen sorgt für Komfort sowie eine angenehme Haptik, während das dicke Kopfteil eine stabile und bequeme Rückenlehne bietet, die sich ideal zum Lesen oder Fernsehen eignet. Dank des neutralen Farbtons passt das Bett in jedes Einrichtungsstil. Die vier Beine des Bettes sind mit einer schönen Holzmaserung versehen und verleihen dem Möbelstück einen Hauch von Luxus. Die durchdachte Konstruktion sorgt dafür, dass selbst in kleinen Räumen ausreichend Stauraum zur Verfügung steht, während der Abstand von ca. 17 cm vom Boden zusätzlichen Platz für Kissen und andere Gegenstände bietet. Technische Details: Liegefläche: 140x200 cm Gesamtmaße: Breite 141 cm, Länge 209 cm, Höhe 101 cm Material: Holzrahmen mit Leinenbezug Funktion: Lattenrost inklusive, keine Boxspring erforderlich Montage: Erforderlich, jedoch leicht zu installieren Verpackung: Lieferung in 2 Paketen Bitte beachten Sie, dass es aufgrund von Lichtverhältnissen zu leichten Farbabweichungen zwischen den Produktbildern und dem tatsächlichen Möbelstück kommen kann.382,18 €*Versand: 23,80 €Sichere Weiterleitung zum Anbieter
-
Was sind die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Daten?
Die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Daten sind Text Mining, Natural Language Processing und Machine Learning. Text Mining ermöglicht die Extraktion von relevanten Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning-Algorithmen können dabei helfen, Muster und Zusammenhänge in den Daten zu erkennen und automatisch Informationen zu extrahieren. **
-
Was sind die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Texten?
Die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Texten sind Text Mining, Natural Language Processing (NLP) und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen durch statistische und linguistische Analyse. NLP ermöglicht die Verarbeitung und Interpretation von natürlicher Sprache, während Machine Learning Algorithmen verwendet, um Muster und Zusammenhänge in den Texten zu erkennen. **
-
Was sind die wichtigsten Techniken zur Informationsextraktion aus unstrukturierten Texten?
Die wichtigsten Techniken zur Informationsextraktion aus unstrukturierten Texten sind Textklassifikation, Named Entity Recognition und Sentimentanalyse. Textklassifikation hilft dabei, relevante Informationen zu identifizieren, während Named Entity Recognition Namen, Orte und andere wichtige Entitäten extrahiert. Sentimentanalyse ermöglicht die Bewertung von Meinungen und Stimmungen in Texten. **
-
Was sind die Schlüsseltechniken für die Informationsextraktion aus unstrukturierten Datenquellen?
Die Schlüsseltechniken für die Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining ermöglicht die Identifizierung von relevanten Informationen in unstrukturierten Texten. Natural Language Processing hilft bei der Verarbeitung und Analyse von natürlicher Sprache. Machine Learning ermöglicht die Automatisierung von Extraktionsprozessen durch das Trainieren von Algorithmen auf vorhandenen Daten. **
* Alle Preise verstehen sich inklusive der gesetzlichen Mehrwertsteuer und ggf. zuzüglich Versandkosten. Die Angebotsinformationen basieren auf den Angaben des jeweiligen Shops und werden über automatisierte Prozesse aktualisiert. Eine Aktualisierung in Echtzeit findet nicht statt, so dass es im Einzelfall zu Abweichungen kommen kann. ** Hinweis: Teile dieses Inhalts wurden von KI erstellt.